Como a medalhão diz onde o dado está, e a modelagem decide como ele é estruturado
Há muitos anos frequento os eventos da comunidade de dados e tecnologia aqui em Vitória-ES, e há três anos sou voluntário no Data & AI Saturday organizado pela TI-ES. Nos eventos, o que mais aproveito são os intervalos, no café ou no almoço. Procuro quem já resolveu o problema em que estou travado, pergunto qual é a stack que está sendo usada, o que andam estudando e o que está emperrando o trabalho.
Os assuntos variam de um evento para outro. Um deles, porém, sempre aparece: a Arquitetura Medalhão. As perguntas costumam ser destas:
Por muito tempo eu respondi a cada uma separadamente. Com o tempo, percebi que todas partem da mesma premissa: a de que a medalhão é um modelo de dados. Quem pergunta se três camadas bastam espera que as camadas resolvam a estrutura dos dados. E elas não resolvem.
O número de camadas é uma decisão de organização. Ele depende de quem consome o dado, do grau de confiança exigido em cada etapa e do prazo de entrega. Uma camada platinum costuma ser uma Gold construída para um consumidor específico, ou uma técnica de modelagem que acabou ganhando nome de camada. Isso não é um erro. Há empresas em que a separação faz todo sentido.
Esta série mantém as três camadas clássicas. Ao longo dos artigos, vamos mostrar que a variedade que muita gente procura em camadas novas já existe nas técnicas que se aplicam dentro de cada uma delas.
Esse é o meu objetivo aqui. Quero reunir as referências que mostram que esses conceitos já passaram pelo teste do tempo, para que você não carregue a responsabilidade de inventar a melhor arquitetura para o seu lakehouse. Boa parte do trabalho já foi feita, por gente que pensou nesses problemas décadas antes de existir um lakehouse.
A distinção que guia a série cabe em uma frase: a medalhão diz onde o dado está e com que grau de confiança, e a modelagem decide como ele é estruturado.
O título desta parte é praticamente uma tradução de um texto de Joe Reis, Medallion Architecture is NOT a Data Model, publicado em setembro de 2025 na newsletter Practical Data Modeling. Ele descreve Bronze, Silver e Gold como estágios do ciclo de vida do dado, que não determinam o modelo. A comparação que ele usa é boa: a medalhão é tão modelo de dados quanto um estacionamento é um tipo de carro. A Gold, por exemplo, não é sinônimo de Star Schema. Ela pode ser um Snowflake, uma OBT (One Big Table, uma tabela larga), um Information Mart do Data Vault ou uma feature table, dependendo de quem vai consumir.
Na prática, isso significa que cada camada tem uma ou mais técnicas possíveis, e escolher entre elas é trabalho de modelagem:
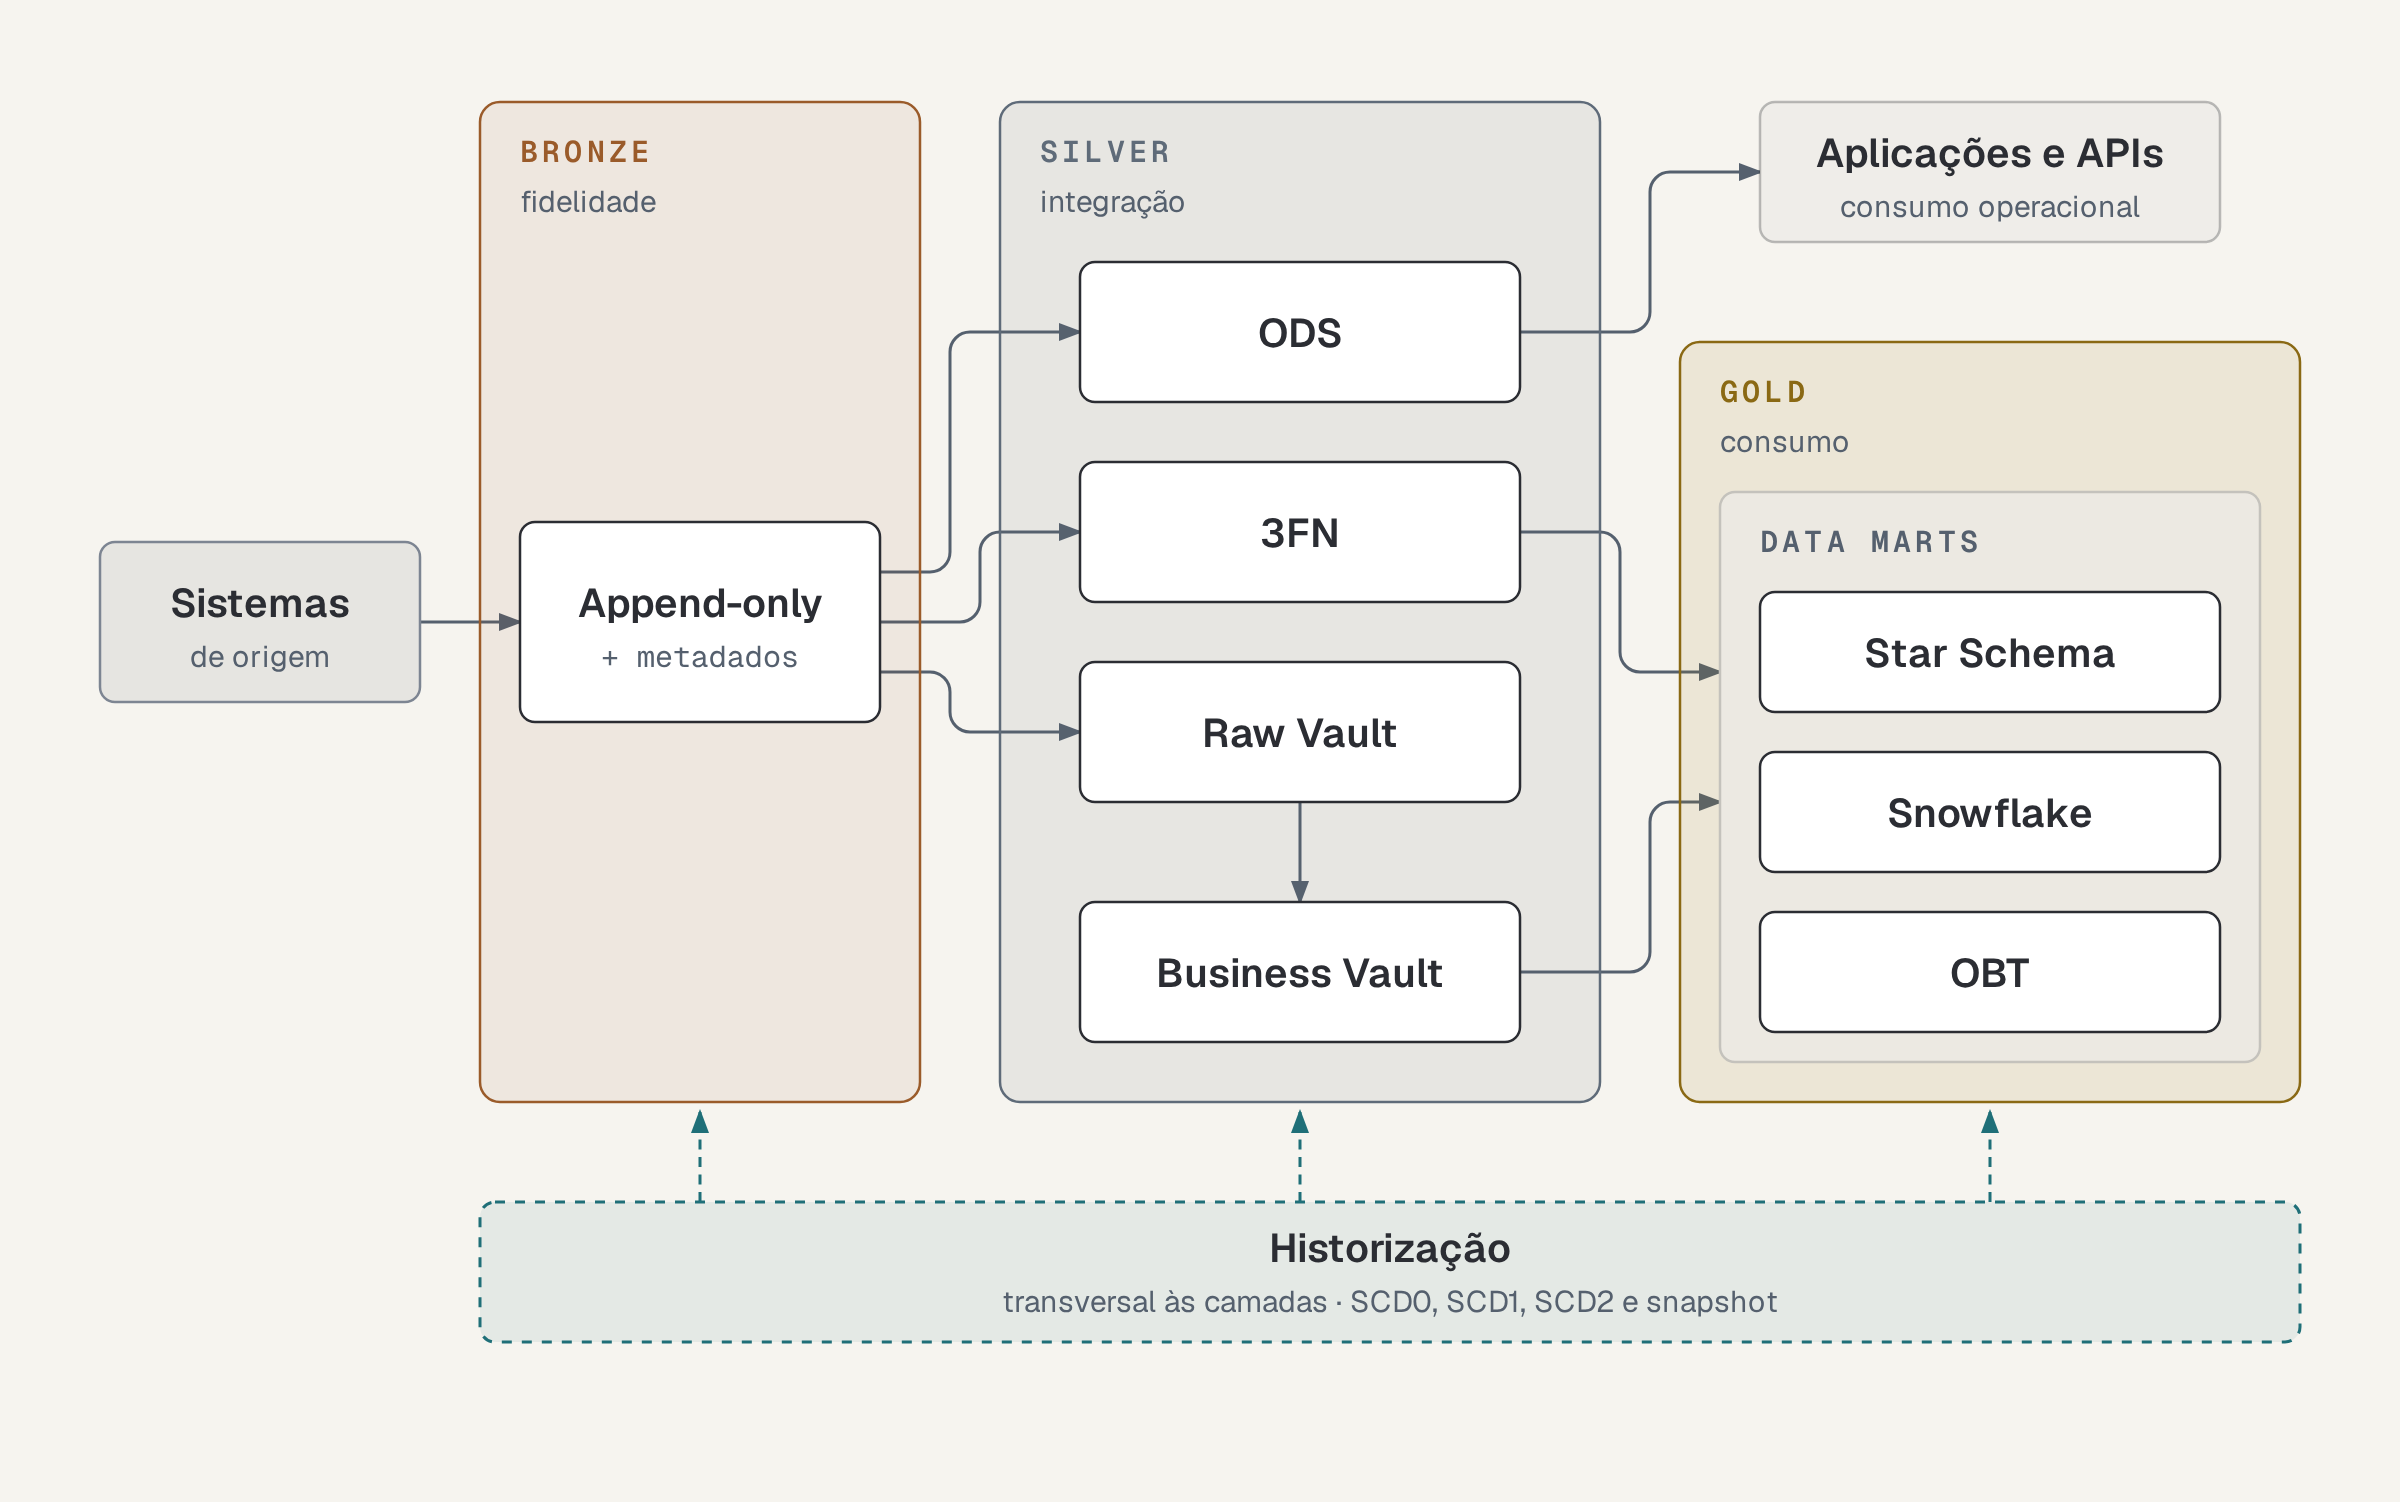
Cada camada, as suas técnicas. A historização não pertence a uma camada: atravessa as três.
Nenhuma dessas técnicas nasceu com o lakehouse. Elas são mais antigas.
Bill Inmon definiu o data warehouse e propôs um modelo corporativo normalizado em Building the Data Warehouse, de 1992. Ralph Kimball publicou The Data Warehouse Toolkit em 1996, o livro que popularizou a modelagem dimensional, com fatos e dimensões. Dan Linstedt concebeu o Data Vault nos anos 1990 e o tornou público em 2000. A versão 2.0 veio em 2013, e o livro Building a Scalable Data Warehouse with Data Vault 2.0, em 2015.
O que mudou com o lakehouse foi o armazenamento e o processamento: arquivos abertos, separação entre storage e compute, streaming e batch na mesma plataforma. Os problemas que essas técnicas resolvem continuam os mesmos. Integrar sistemas que descrevem o mesmo cliente de jeitos diferentes continua difícil. Responder a uma pergunta de negócio sem dez joins também.
Uma objeção que ouço com frequência é que não há tempo para modelar. Joe Reis respondeu a ela em We Don’t Have Time For Data Modeling e voltou ao tema na série Data Modeling is Dead (Again) (Parte 1 e Parte 2). O argumento dele é que modelar mistura trabalho de entender o negócio com trabalho de entrega, e que o primeiro não cabe numa sprint curta. Isso pede um processo adaptado, não o abandono do modelo, porque modelo ruim é um risco que só aparece mais tarde. Esta série não vai se alongar nessa defesa. Ela parte do princípio de que você já sentiu falta de um modelo em algum momento e quer saber qual escolher.
E não há uma técnica melhor do que as outras. Em cada situação, alguma se encaixa melhor. Por isso, todo artigo da série traz duas seções obrigatórias: quando usar e quando evitar.
A explicação mais comum da medalhão é uma receita: a Bronze copia, a Silver limpa e a Gold agrega. Ela é fácil de lembrar, mas não ajuda a decidir nada. Nesta série, preferimos descrever cada camada pela pergunta que ela responde.
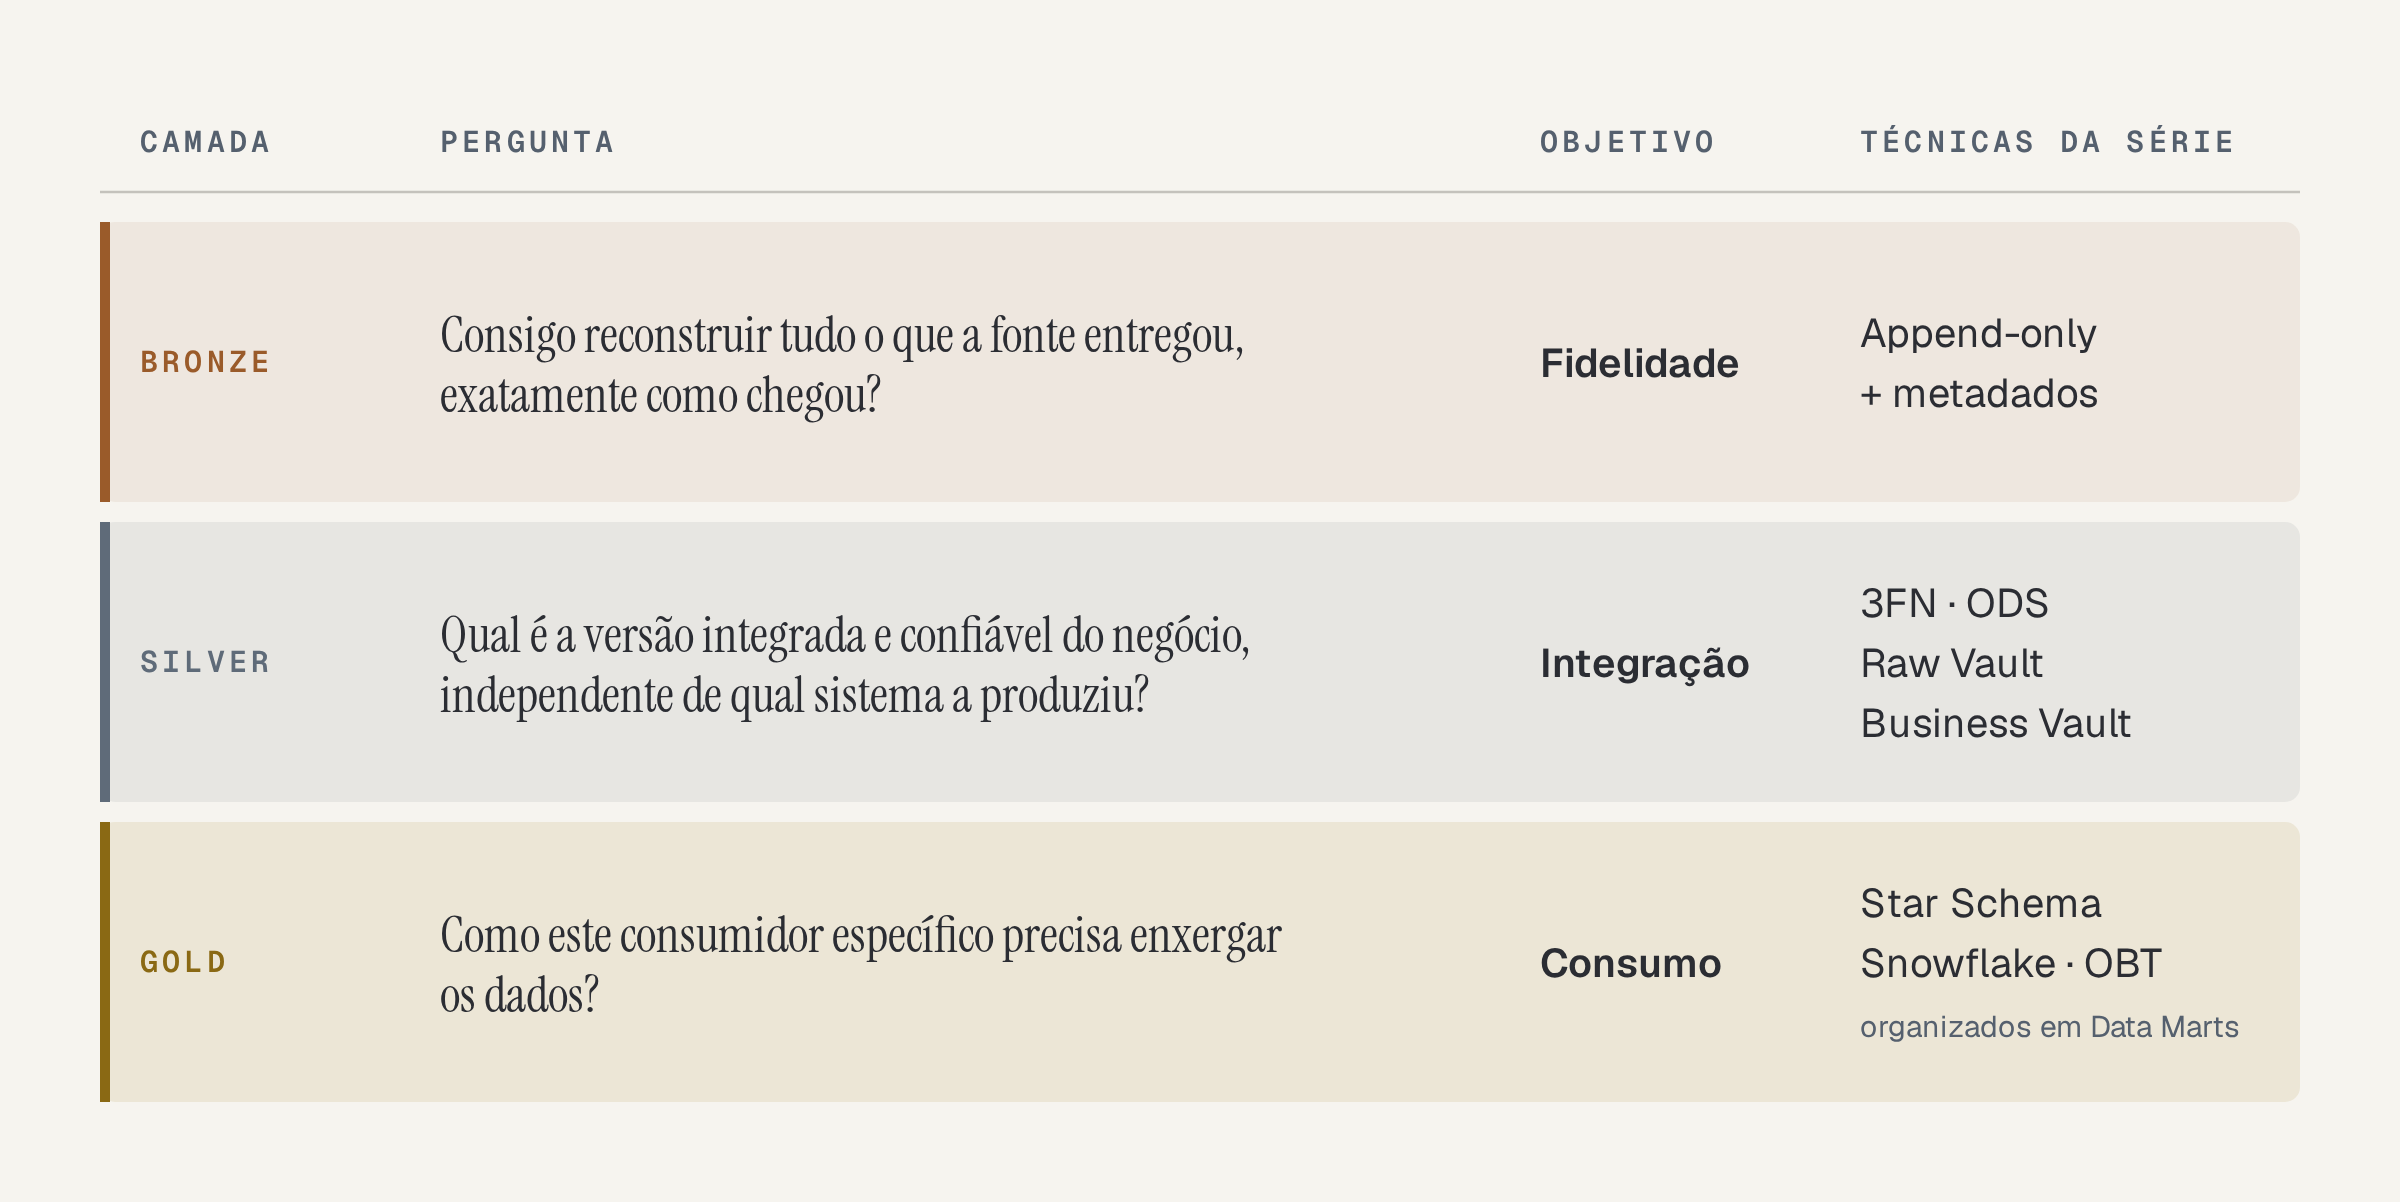
Alguns pontos dessa tabela merecem explicação.
Na Bronze, o curso Data Modeling Strategies fala em “nenhuma modelagem aplicada”: a única decisão de design é preservar a fidelidade à origem. Concordamos, com um acréscimo. Preservar a fidelidade exige escolher quais metadados de ingestão acompanham cada linha, e essa é a única decisão de modelagem da Bronze. É ela que permite responder à pergunta da camada, e é o assunto da Parte 1.
Na Gold, a palavra que importa é “este”, no singular. Uma Gold atende a um consumidor. Quando dois consumidores precisam de visões muito diferentes, aparecem duas Golds, ou uma Gold e uma camada com outro nome. É daí que surge a platinum.
A historização ficou fora da tabela de propósito. Guardar o que mudou não é tarefa de uma camada só. Ela aparece na Silver, nos satélites do Data Vault e nas dimensões da Gold. Por isso tem um artigo próprio, logo depois da Bronze.
O ODS também tem uma particularidade. Ele fica na Silver, mas seu consumidor é operacional: aplicações e APIs que querem o estado atual do negócio. É a única técnica da Silver que não existe para alimentar a Gold.
São doze partes, cada uma com uma pergunta.
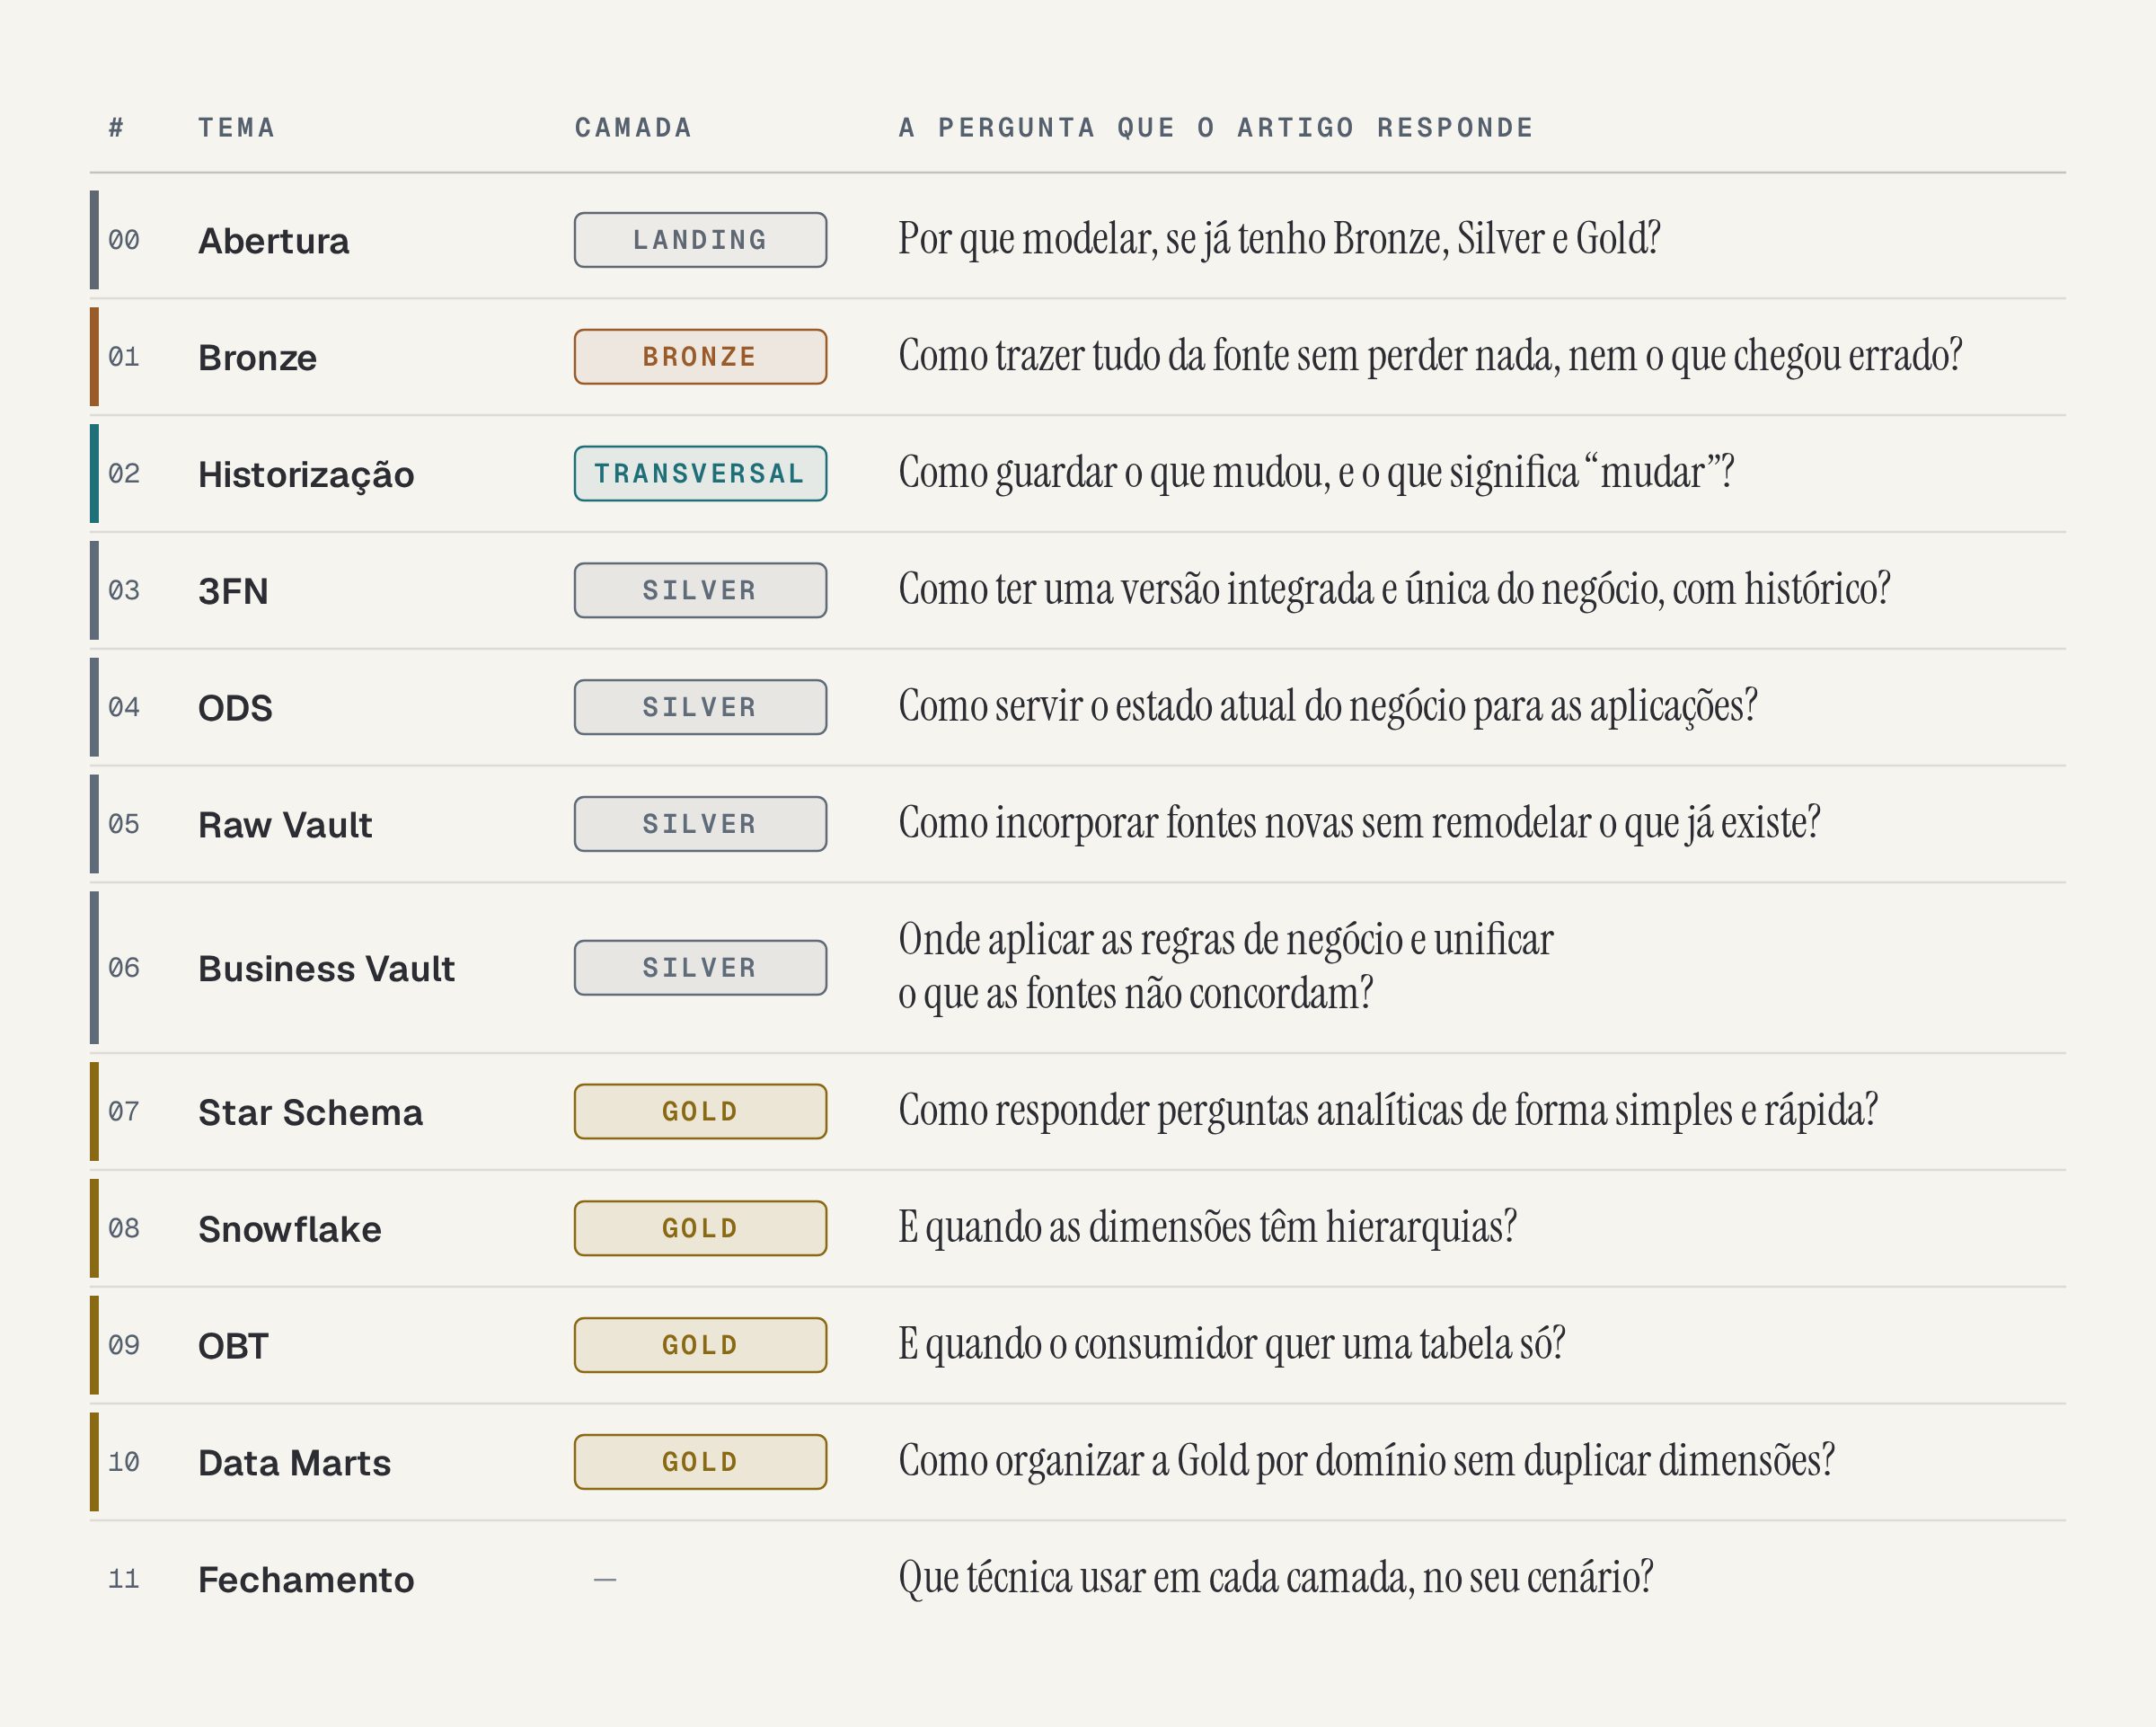
A ordem tem um motivo. A historização vem logo depois da Bronze porque quase tudo o que vem a seguir usa algum tipo de SCD, e é melhor explicar isso uma vez só. Na Silver, a 3FN vem antes do ODS: depois de construída a 3FN, o ODS fica fácil de explicar como as mesmas entidades sem histórico, servindo outro consumidor. O Data Vault vem por último na Silver, motivado por uma aquisição que você vai conhecer na próxima seção. Na Gold, a estrela abre o bloco, porque Snowflake e OBT são variações dela, e os Data Marts organizam tudo o que veio antes.
Dois temas atravessam a série. Um é o Data Vault, que começa na Silver com o Raw Vault, ganha regras no Business Vault e chega à Gold nos Information Marts do artigo 10. O outro é a historização, apresentada na Parte 2 e retomada na 3FN, no Vault e nas dimensões.
Cada artigo termina com um cartão-resumo, sempre com os mesmos atributos: histórico, latência, consumidor, complexidade e custo de manutenção. O artigo 11 junta esses cartões num guia de decisão. Se você só puder ler um artigo da série, que seja esse.
Um artigo novo sai toda segunda-feira, aqui no Substack, com um resumo e o cartão-resumo no LinkedIn. Assine a série para receber cada parte assim que ela for publicada.
Explicar modelagem com exemplos soltos, como uma tabela de clientes aqui e uma de pedidos ali, funciona até a primeira pergunta difícil. Por isso, toda a parte prática da série usa uma empresa só, o Grupo ModelBricks.
O ModelBricks é uma holding brasileira de transporte com várias empresas:
O grupo também tem negócios de combustíveis, energia solar e locação, que aparecem de passagem e ficam fora dos exemplos.
Trabalhei por mais de quatro anos numa holding de transporte e logística, e hoje presto consultoria a um grupo de concessionárias. Ou seja, vivo esse cenário no dia a dia. Escolhi uma holding de transporte porque os negócios se cruzam. A mesma pessoa compra passagem na Viação e faz seguro na corretora. A mesma empresa contrata frete da Cargas e compra caminhão da concessionária. E o caminhão vendido pela concessionária pode voltar como frota do próprio grupo.
O problema é que cada empresa enxerga o cliente do seu jeito, e ninguém no grupo tem uma visão única dele. Quando o Vale do Sol entra, chega uma segunda maneira de ver o mesmo passageiro, com outros cadastros e outras regras. Essa compra vai acompanhar a série: aparece na 3FN, motiva o Raw Vault e volta no Business Vault, quando for preciso decidir qual das duas versões de um passageiro vale.
Essa variedade dá a cada técnica um problema real para resolver, em vez de um exemplo criado sob medida para ela.
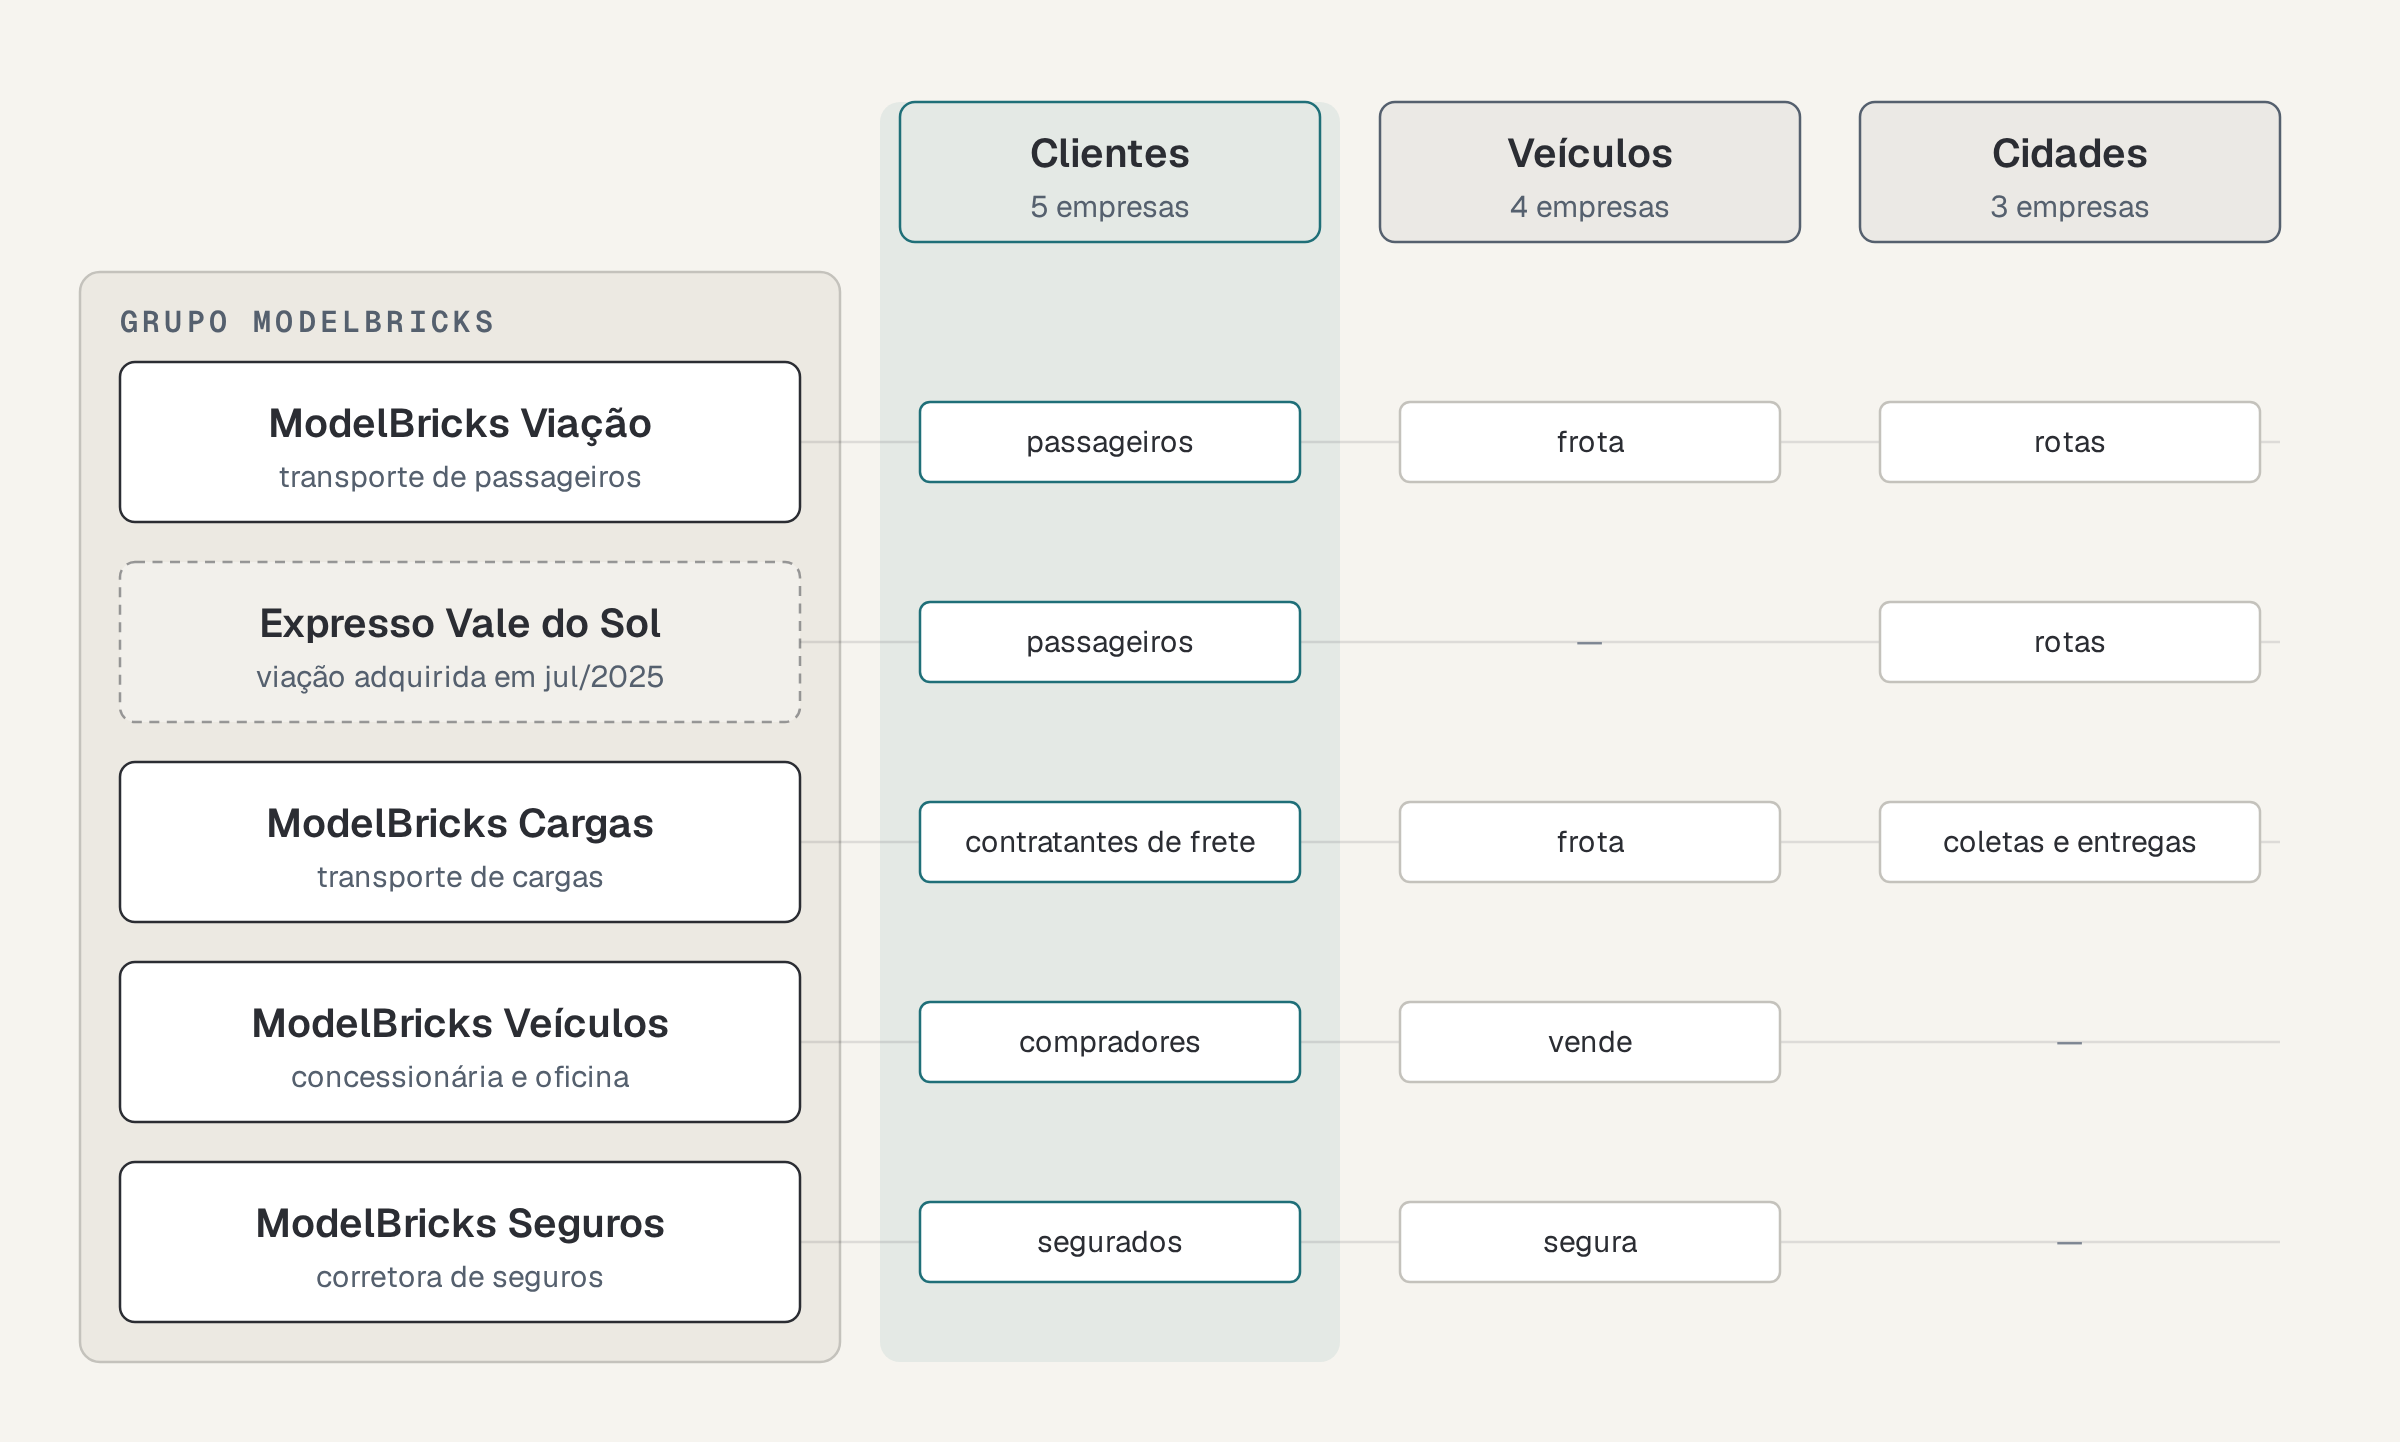
O que as empresas do grupo compartilham. Todas têm clientes, e nenhuma enxerga o cliente das outras.
O Grupo ModelBricks é fictício. A estrutura com várias divisões foi inspirada em grupos brasileiros de transporte, como o Grupo Águia Branca. Empresas, sistemas, pessoas e números são sintéticos. A inspiração fica só no desenho das empresas. Nenhum dado da série vem do Grupo Águia Branca nem das empresas em que trabalhei ou para as quais presto consultoria: tudo é gerado por código, a partir de regras que escrevemos para a série.
A parte prática não é uma coleção de exemplos soltos. Ao longo da série, vamos construir um único lakehouse do Grupo ModelBricks, camada por camada, e cada artigo acrescenta uma parte ao que os anteriores deixaram pronto:
Por isso, a parte prática precisa seguir a ordem dos artigos. Se você abrir o código do Star Schema sem ter construído a Bronze e a Silver, não vai haver dados para ele ler. Isso é de propósito: numa medalhão de verdade, cada camada consome a anterior, e a ordem da série reproduz esse caminho. Cada artigo lembra, logo no começo da parte prática, o que precisa estar pronto antes dele.
A ordem vale para quem vai executar o código. Para quem só quer ler, cada artigo explica o seu problema e a sua técnica do começo ao fim.
Toda a parte prática fica num repositório público no GitHub: data-modeling-on-databricks. Tudo roda no Databricks Free Edition, sem custo. Antes da primeira camada, precisamos de duas coisas: o projeto, que leva o código ao workspace, e a landing zone, onde os sistemas do Grupo ModelBricks deixam os seus arquivos.
Numa empresa real, os dados não nascem no lakehouse. Eles chegam dos sistemas de origem: o ERP exporta arquivos Parquet toda noite, o marketplace devolve páginas de uma API em JSON, o sistema legado manda CSV com acentuação de outra época. A landing zone é o lugar onde esses arquivos chegam, do jeito que a fonte os entregou, antes de qualquer camada da medalhão tocar neles.
Ela não é a Bronze. A Bronze é a primeira camada modelada: tabelas que guardam tudo o que chegou, com os metadados da ingestão. A landing é só a caixa de entrada. Ninguém a consulta para responder uma pergunta de negócio, e nenhum arquivo muda depois de chegar: um lote novo é sempre um arquivo novo.
No Databricks, a landing do projeto fica em Volumes do Unity Catalog, o objeto feito para guardar arquivos, e não tabelas, com o mesmo controle de acesso das tabelas. Cada sistema de origem tem um schema no catálogo da Bronze e, dentro dele, um Volume chamado landing. Os arquivos ficam em pastas pela data em que chegaram:
/Volumes/bronze_dev/embarque/landing/clientes/2025-03-14/clientes_20250314_0001.jsonComo o Grupo ModelBricks é fictício, os sistemas dele também são. Quem faz o papel deles é um gerador de dados que escrevemos para a série, com o dbldatagen e nomes, endereços e documentos em português. Ele cria primeiro a “verdade” do grupo (as pessoas, as empresas, os veículos, as rotas) e depois a registra como cada sistema registraria: com chave própria, formato próprio, padrão de entrega próprio (CDC, fotos completas, alterações do dia, páginas de API, telemetria) e defeitos próprios. Os defeitos estão lá de propósito: CPF fora do padrão, contato vazio, operação entregue duas vezes, evento atrasado, acento quebrado. Cuidar deles é trabalho da Silver.
O gerador também guarda um relógio simulado. A carga inicial deixa na landing tudo o que os sistemas teriam entregado de janeiro de 2024 a dezembro de 2025, e o relógio para em 31 de dezembro de 2025. Depois, um comando avança o tempo e faz chegar os arquivos dos dias seguintes, como numa operação de verdade. Os dados são determinísticos: o mesmo comando gera os mesmos arquivos, então os números que você encontra batem com os dos artigos.
O código chega ao workspace por um Declarative Automation Bundle, o antigo Databricks Asset Bundle. O nome mudou em março de 2026, mas o comando continua sendo databricks bundle, e você ainda vai encontrar o nome antigo em muitos materiais. O bundle é só o meio de entrega: ele empacota o gerador e os recursos de todos os artigos, e um comando os envia ao workspace, sem importar notebook à mão.
São seis passos, feitos uma vez só:
Instale a Databricks CLI e o uv, o gerenciador de pacotes e de ambientes Python que o projeto usa. O deploy também depende dele para empacotar o gerador.
Clone o repositório e entre na pasta dele:
git clone https://github.com/deywillan/data-modeling-on-databricks.git
cd data-modeling-on-databricks
Crie o ambiente virtual e instale as dependências. O uv baixa o Python 3.12, se ele ainda não estiver na sua máquina:
uv venv --python 3.12
uv pip install -r requirements.txt
O ambiente serve para rodar na sua máquina os scripts de conferência e os testes do gerador. Os jobs e os pipelines não dependem dele, porque rodam no workspace.
Autentique a CLI no seu workspace. O comando abre o navegador para o login:
databricks auth login --host <url-do-seu-workspace> --profile <seu-perfil>Na raiz do repositório, envie o projeto ao workspace:
databricks bundle deploy -p <seu-perfil>Construa a landing zone:
databricks bundle run 00_setup -p <seu-perfil>O último passo leva cerca de seis minutos e deixa cerca de 2 GB de arquivos na landing. Ao final, o workspace tem três catálogos, um por camada:
| Catálogo | O que tem ao fim da Parte 0 |
|---|---|
bronze_dev | um schema por sistema de origem, cada um com a sua landing preenchida, e o relógio simulado |
silver_dev | só o gabarito: tabelas com a verdade por trás dos arquivos, para conferir a integração mais adiante (os pipelines nunca o leem) |
gold_dev | nada ainda |
Nenhuma tabela da Bronze existe ainda, e é assim que deve ser. A landing está pronta, e a Parte 1 parte dela para montar a Bronze.
O passo a passo detalhado, com os parâmetros e com o que fazer se algo der errado, está no README do repositório, que é atualizado com mais facilidade do que um artigo publicado.
O Free Edition é gratuito, mas não é ilimitado, e alguns limites mudam o jeito de executar a série. Os que mais pesam aqui, segundo a documentação:
Na prática, a regra é simples: um job ou pipeline por vez, na ordem dos artigos. O 00_setup foi dimensionado para caber com folga, em cerca de seis minutos. Se o seu workspace já está sendo usado para outras coisas, rode o setup com uma escala menor (o README explica como), sabendo que os números dos artigos usam a escala padrão.
A documentação não diz o tamanho da cota diária nem o que conta como “tipo de pipeline”, e esses limites podem mudar. Antes de começar, vale conferir a página de limitações do Free Edition.
Se fosse para guardar uma frase deste artigo, seria esta: a medalhão diz onde, e a modelagem diz como. As perguntas que ouço nos cafés dos eventos ficam mais simples quando separamos as duas coisas.
Na próxima segunda-feira, começamos pela Bronze, a partir da landing que acabamos de construir. Ela parece ser só uma cópia de arquivos, mas exige uma decisão de modelagem, e é essa decisão que permite reconstruir tudo o que a fonte entregou.
Uma última coisa. A série nasceu de conversas, e eu gostaria que continuasse assim. Que dúvida você já teve sobre a medalhão? Qual discussão sobre camadas você já viu travar um projeto? Deixe nos comentários. Quem sabe ela vira assunto de um dos próximos cafés.
Assine a série aqui no Substack para receber cada parte, e acompanhe o código no repositório data-modeling-on-databricks.